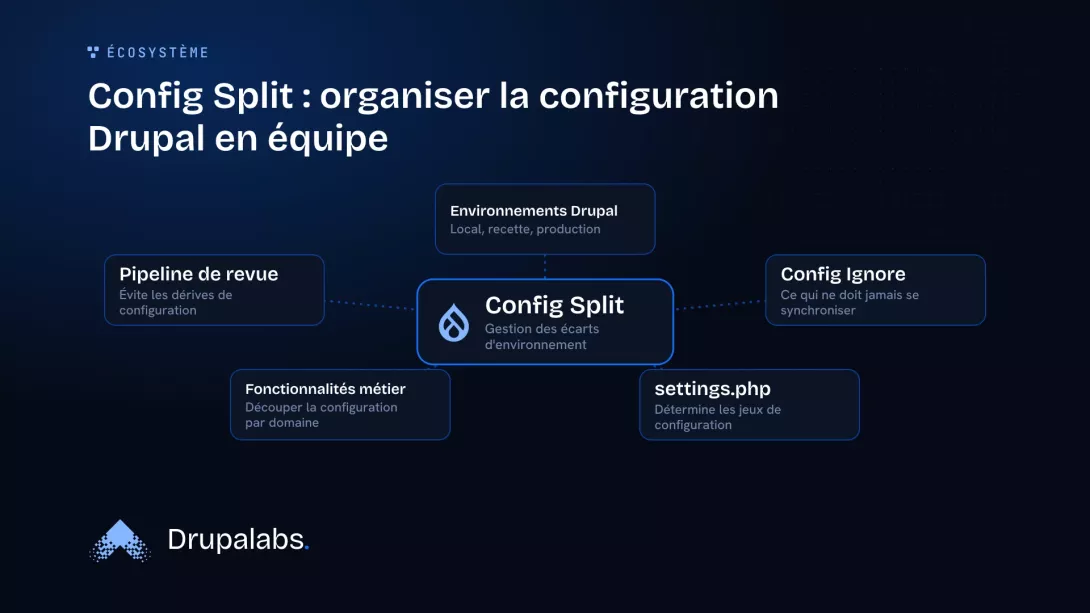
Une configuration Drupal qui diverge entre le poste d'un développeur, la recette et la production coûte cher en silence : un module activé en local mais absent en production, un champ modifié localement qui disparaît à l'import. Config Split et un pipeline de revue structuré évitent cette dérive, en séparant ce qui doit voyager d'un environnement à l'autre de ce qui doit rester local.
Pourquoi les dérives de configuration finissent par coûter cher
Elle se repère souvent trop tard : au moment du déploiement, quand un module activé en local manque en production ou qu'un champ modifié localement disparaît à l'import. Ce qui coince, c'est l'organisation : sans séparation claire entre ce qui doit voyager d'un environnement à l'autre et ce qui doit rester local, chaque export devient un pari.
Découper la configuration par fonctionnalité métier
Découpez la configuration par fonctionnalité métier : un bloc par domaine, par exemple commerce, éditorial, recherche. Config Split et Config Ignore gèrent ensuite les différences d'environnement : le premier pour ce qui change selon l'environnement, le second pour ce qui ne doit jamais se synchroniser. Ce sont deux modules contrib, pas des fonctionnalités du core Drupal.
Config Split : des jeux de configuration par environnement
Config Split définit des jeux de configuration exportés vers des répertoires séparés à l'export, puis fusionnés à l'import. C'est settings.php qui détermine quels jeux sont actifs pour chaque environnement : un module de debug activé uniquement en local, par exemple, sans qu'il n'atteigne jamais la production.
Depuis la version 2.x, le module va plus loin : il peut scinder des clés individuelles d'un même fichier de configuration via un « config patch », une fonctionnalité activée par défaut mais que vous pouvez désactiver pour revenir au comportement de la 1.x si votre équipe préfère des fichiers de split entiers.
Config Ignore : garder certains réglages hors synchronisation
Config Ignore répond à un autre besoin : conserver certains réglages en place, sans les réappliquer à l'import. La documentation du module est explicite sur une limite importante : ne jamais ignorer core.extension, sous peine de bloquer l'activation de modules via import. Pour une configuration qui varie par environnement, c'est Config Split qu'il faut utiliser, pas Config Ignore.
Un autre point distingue les versions : jusqu'à la 2.x, le module n'ignorait la configuration qu'à l'import. Depuis la 3.x, en mode simple, il ignore à l'import et à l'export. Une nuance à vérifier si votre équipe migre d'une version à l'autre.
Le pipeline export, revue, import
Le flux de travail standard tient en trois temps : on exporte la configuration locale, on la revoit comme n'importe quel changement de code, puis on l'importe sur la cible. C'est cette étape de revue, souvent sautée sous pression de calendrier, qui permet de voir un écart avant qu'il n'atteigne la cible.
drush config:export / config:import et la confirmation avant application
Côté outillage, drush config:export vide le répertoire de synchronisation avant de le réexporter intégralement, et drush config:import affiche la liste des changements détectés puis demande une confirmation explicite avant de les appliquer, comme le décrit la documentation du workflow Drush. Cette invite est le dernier moment où quelqu'un lit réellement ce qui va changer.
Revue de diff et checklist avant un import
Importer de la configuration supprime aussi celle qui est absente des fichiers importés. C'est justement ce qui garantit la prévisibilité du mécanisme : si un fichier n'est pas dans l'export, il n'existe plus après l'import. Un diff non relu peut donc effacer un réglage ajouté en urgence sur la cible. La checklist minimale avant tout import : lire le diff ligne par ligne, vérifier qu'aucun fichier attendu ne manque, et confirmer avec quelqu'un d'autre que l'auteur de l'export.
Les garde-fous : ce que Drupal bloque, ce que vous devez faire vous-même
Sur ce pipeline, dans les pages de documentation citées ici, un seul contrôle bloquant automatique apparaît : la correspondance d'UUID de site. Tout le reste, à commencer par la sauvegarde avant synchronisation, reste entre vos mains.
UUID du site : la vérification automatique qui bloque un import mal ciblé
Avant d'appliquer un import, Drupal compare l'UUID du site cible (system.site:uuid) à celui enregistré dans les fichiers exportés, comme l'explique la documentation sur la gestion de configuration. Si les deux ne correspondent pas, l'import est purement et simplement refusé. C'est le seul garde-fou automatique identifié sur ce pipeline, et il protège contre un cas précis : pousser par erreur la configuration d'un site sur un autre. Modifier l'UUID via settings.php ou drush cset reste possible, mais c'est un contournement technique à manier avec prudence, pas une étape de routine.
Dump de base avant synchronisation : la recommandation manuelle
À côté de ce contrôle automatique, la documentation officielle recommande fortement de faire un dump de base de données avant chaque synchronisation de configuration, formulé sans détour : cela « pourrait vous sauver la vie ». Mais c'est une recommandation humaine à intégrer à votre procédure, pas un contrôle que Drupal applique de lui-même.
Secrets : ce qui ne doit jamais entrer dans le sync
La configuration Drupal sert à synchroniser ce qui doit se propager de dev vers prod. L'API State, elle, sert les valeurs locales qui ne doivent justement pas voyager entre instances, comme le précise la documentation de l'API de configuration. Un secret, une clé d'API ou un identifiant de service tiers n'a sa place ni dans la configuration versionnée, ni forcément dans le State : il relève plutôt de settings.php ou de variables d'environnement, en dehors du périmètre que ce pipeline synchronise.
Contenu de référence vs configuration : où tracer la frontière
Le contenu de référence vit dans les entrées elles-mêmes, en base, pas dans les fichiers de configuration : il ne suit pas le mécanisme d'export/import. La frontière à tracer est simple : la configuration décrit la structure et le comportement du site, le contenu de référence se gère avec d'autres outils, migration, scripts de peuplement, ou gestion manuelle. Mélanger les deux crée de la confusion : on prête à l'export une protection qu'il n'a jamais eue pour les données.
Que faire quand un import casse la prod
C'est là que la préparation en amont paie. Si vous avez suivi la recommandation du dump de base avant synchronisation, la restauration consiste à revenir à cette sauvegarde, puis à rejouer l'export depuis un état connu. Sans ce dump, il faut reconstruire les réglages manquants à partir du diff que vous avez relu avant l'import, ce qui souligne pourquoi cette étape de revue n'est jamais du temps perdu.
Conclusion : ce qui rend un déploiement prévisible
Une organisation de configuration Drupal qui tient dans le temps repose sur peu de choses : une configuration découpée par fonctionnalité, des splits qui portent les différences d'environnement, une revue de diff systématique avant chaque import, un dump de base avant chaque synchronisation, et une frontière nette entre configuration, secrets et contenu de référence. Le garde-fou automatique identifié dans la documentation, l'UUID de site, ne remplace aucun de ces réflexes manuels.
Si votre équipe découvre encore ces dérives au moment du déploiement, un diagnostic situe le point de rupture de votre pipeline. Demander un diagnostic.