Pourquoi RSC amplifie le problème de payload
Avant les React Server Components, le payload JSON:API arrivait côté client, dans le navigateur. Le navigateur avait déjà chargé du JavaScript, le réseau était partagé avec d'autres ressources, et un payload un peu lourd passait souvent inaperçu dans les DevTools.
Avec RSC, le composant serveur fetche directement depuis le serveur Node.js qui héberge Next.js. La requête JSON:API ne traverse pas le réseau public vers le navigateur, mais elle traverse quand même le réseau interne entre Next.js et Drupal. Et surtout, le résultat de ce fetch alimente le rendu côté serveur : si la réponse est lente ou volumineuse, la génération HTML est retardée, et le Time to First Byte de la page monte avec.
Next.js sérialise les données passées des Server Components aux Client Components sous forme de RSC payload, un format propriétaire transmis au navigateur. Un objet JSON:API brut avec tous ses champs, ses relations incluses et ses métadonnées se retrouve dans ce payload. Moins on en transporte, plus ce payload est compact et plus le First Contentful Paint arrive vite.
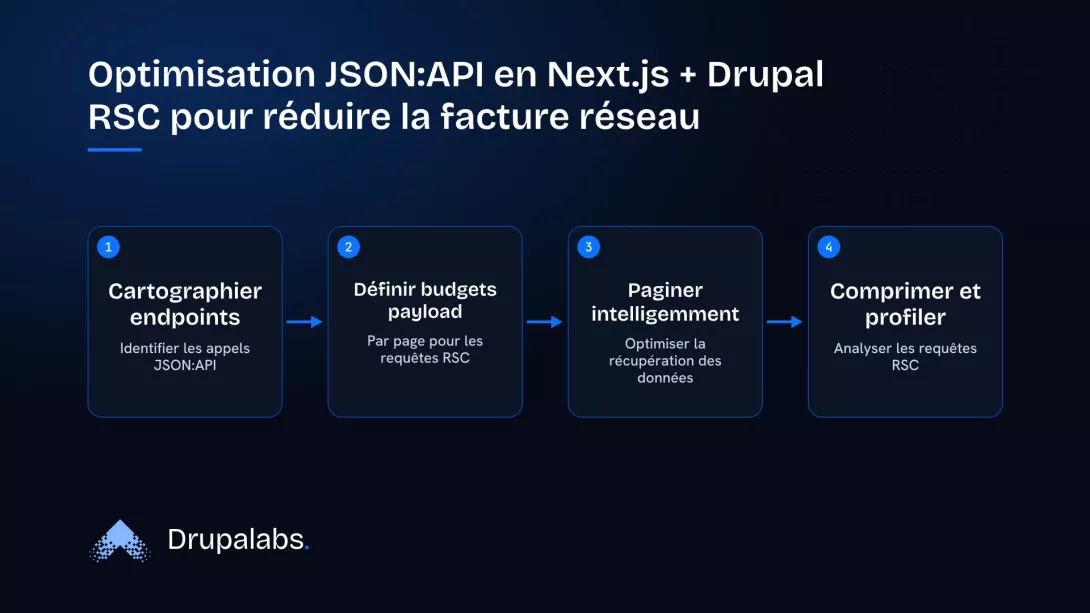
Cartographier les endpoints avant de les optimiser
On ne peut pas budgétiser ce qu'on ne mesure pas. La première étape est de lister, pour chaque page Next.js, les requêtes JSON:API déclenchées pendant le rendu. Quatre patterns signalent un problème de payload :
- Une réponse JSON:API qui inclut des relations non utilisées par la page (paramètre
includetrop large). - Des champs demandés que le composant React n'affiche pas (absence de
fields[node--article]dans la requête). - Une liste paginée qui retourne 50 items alors que la page n'en affiche que 6.
- Des relations imbriquées à plusieurs niveaux qui se répètent dans le payload (le même auteur sérialisé 12 fois dans un listing).
Sparse fieldsets : ne demander que ce qu'on affiche
JSON:API implémente les sparse fieldsets de la spécification JSON:API 1.1. Le paramètre fields[<type>] restreint les champs retournés pour chaque type de ressource. Sans sparse fieldsets, une requête sur node--article retourne tous les champs définis dans Drupal. Pour un composant qui affiche uniquement le titre, le chapo et l'image de couverture, les 90 % restants traversent le réseau pour rien.
Une pratique utile : créer un fichier de constantes qui liste les fieldsets par type de page. Ces constantes documentent explicitement ce que chaque template de page consomme. Quand le design évolue et qu'un nouveau champ doit être affiché, on modifie le fieldset correspondant, et la dépendance entre front et back est visible dans le dépôt.
Budgets de payload par page
Une fois les fieldsets définis, on peut mesurer et poser des seuils. Un budget de payload est simple : pour chaque type de page, on définit une taille maximale de réponse JSON:API au-dessus de laquelle un avertissement ou une erreur de build est déclenchée. Ces tests s'exécutent dans la CI contre un environnement Drupal de staging. Ils alertent quand un changement de modèle de contenu ou de configuration JSON:API fait grossir les réponses au-delà du seuil défini.
Paginer intelligemment
JSON:API Drupal propose deux stratégies de pagination principales : page[limit] / page[offset], et une pagination par curseur via le module jsonapi_cursor_pagination. La pagination offset est simple mais coûteuse sur les grandes collections. La pagination par curseur évite ce coût en utilisant un identifiant opaque qui pointe directement au bon endroit dans le dataset.
Une règle simple : page[limit] doit correspondre exactement au nombre d'items affichés à l'écran sur le rendu initial. Un page[limit] trop grand ne pose pas seulement un problème de payload : il crée un écart entre ce que le cache Next.js retient et ce que le composant affiche, ce qui complique la revalidation par tag.
Compression : activer ce qui existe déjà
Drupal peut retourner des réponses gzip ou brotli si le header Accept-Encoding est envoyé dans la requête. Next.js ne l'envoie pas automatiquement dans un fetch serveur. La compression doit être activée au niveau du serveur web (nginx ou Apache) pour les types MIME JSON. JSON se comprime bien : un payload de 100 Ko descend typiquement entre 15 et 25 Ko après compression brotli.
Profiler dans le contexte RSC
Trois métriques méritent d'être surveillées en CI : la taille des payloads JSON:API, le nombre de requêtes par page (un Server Component qui déclenche plus de 5 requêtes JSON:API doit être revu), et le temps de réponse Drupal en staging (si le P95 d'un endpoint JSON:API dépasse 300 ms en staging, c'est un signal d'alerte).
Ce que ça change pour l'expérience éditoriale
Quand les sparse fieldsets restreignent les données côté front, ils ne changent rien à ce que les rédacteurs voient dans l'interface d'administration Drupal. L'éditeur continue à remplir tous les champs du type de contenu. Seule la réponse JSON:API consommée par Next.js est filtrée. Si un nouveau champ est ajouté dans Drupal et doit apparaître sur le front, un développeur doit ajouter ce champ dans le fieldset correspondant : c'est une décision intentionnelle, pas une contrainte cachée.
Par où commencer
- Ajouter le logger de requêtes sur les trois pages les plus chargées du site.
- Identifier les champs présents dans les réponses JSON:API mais absents du rendu HTML.
- Ajouter des sparse fieldsets sur ces trois pages.
- Mesurer la taille des réponses avant et après.
- Formaliser les budgets mesurés comme seuils de CI.
- Activer la compression brotli côté Drupal si ce n'est pas déjà fait.